您当前所在位置:首页-公司新闻-《不开玩笑,科大讯飞的机器人要参见高考了》
浪潮信息发布元脑 SD200 Ultra 超节点:单机承载 2.8 万亿参数 Kimi K3,Token 时延首次突破 5.85 毫秒
2026-09-21作者:AutoLab来源:品途商业评论
在昨日召开的2026人工智能计算大会(AICC2026)上,浪潮信息正式发布了元脑SD200 Ultra超节点AI服务器及元脑HC2000多元算力机组。
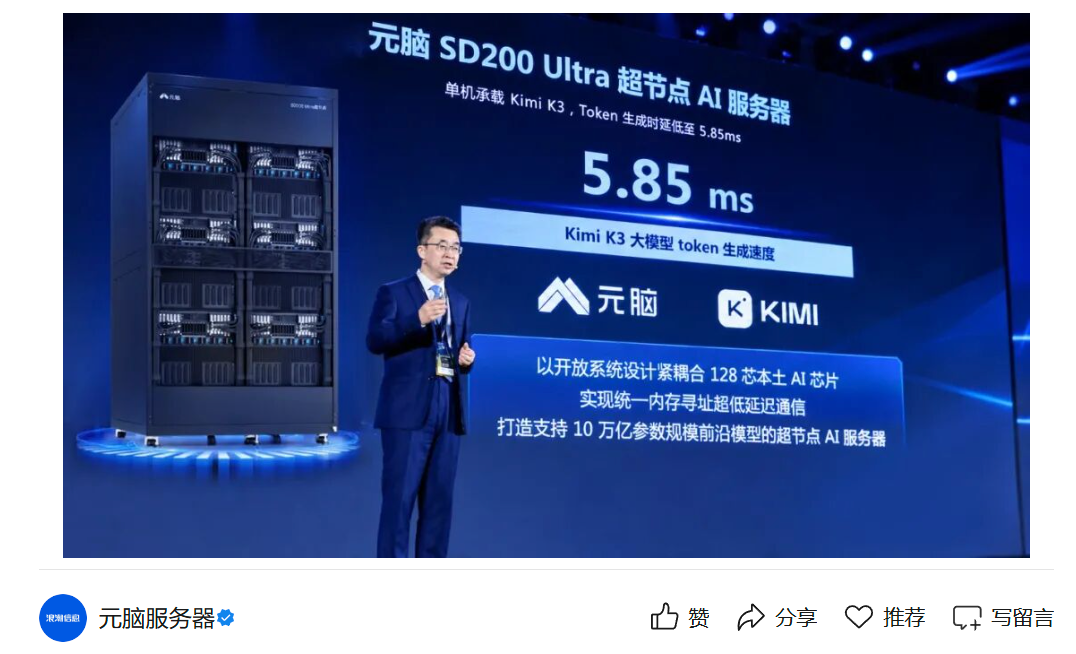
根据官方信息,元脑SD200 Ultra采用国产AI芯片构建,单台设备可支持运行参数规模达2.8万亿的Kimi K3大模型。
浪潮方面指出,SD200 Ultra的Token生成时延首次被控制在5.85毫秒以内,相当于单用户每秒处理170个Tokens,这一速度是业界平均水平的5倍。该机型还具备单机运行10万亿参数规模前沿模型的能力。
注:Token生成时延是指大模型每输出一个词元所需的平均时间,是衡量推理响应速度的关键指标。
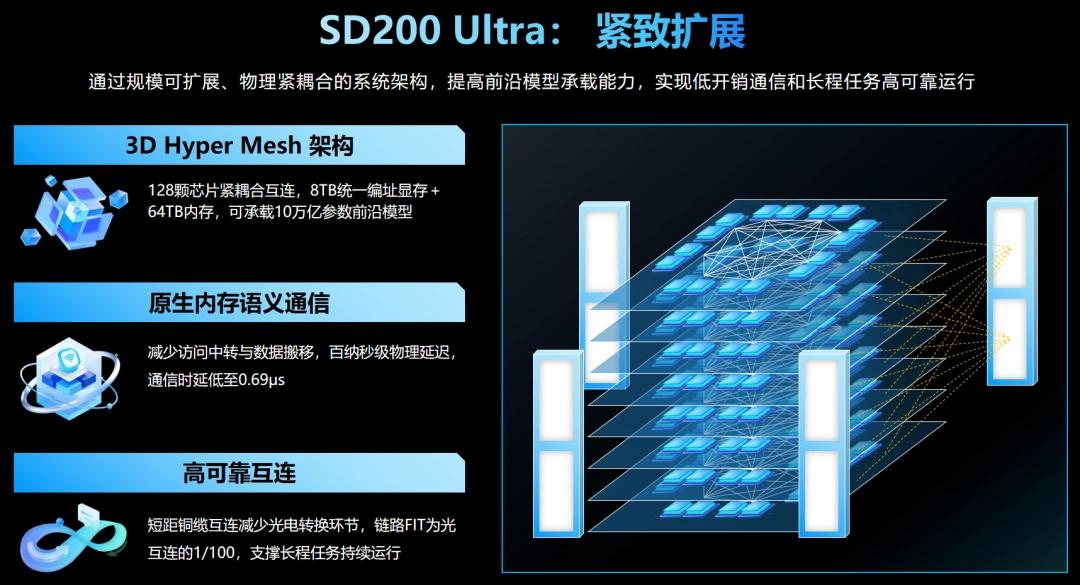
SD200 Ultra采用了3D Hyper Mesh架构,紧密耦合了128颗本土AI芯片,提供了8TB的统一编址显存和64TB内存。系统基于原生内存语义通信,通信时延低至0.69微秒。
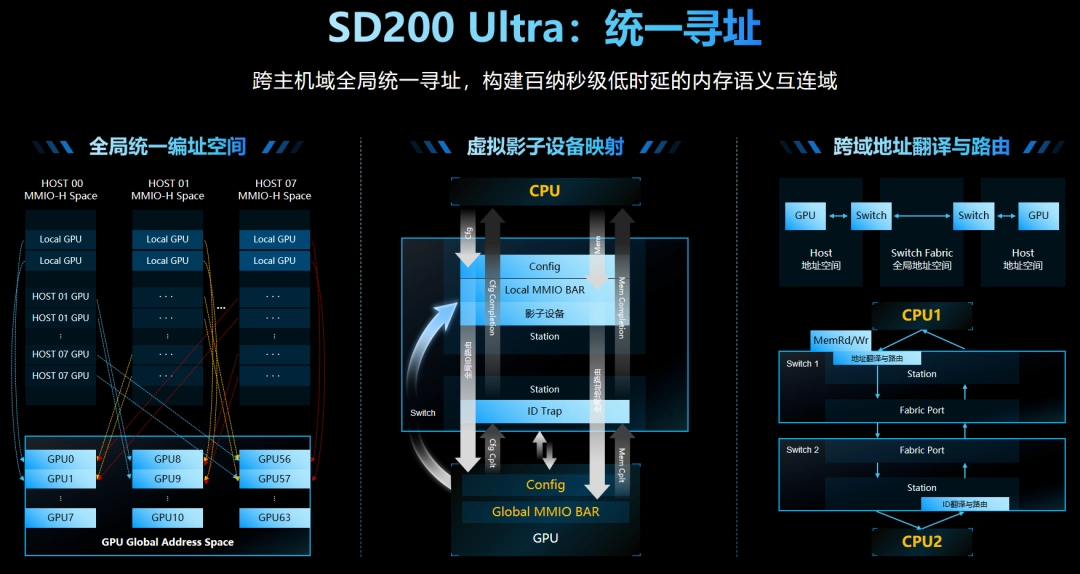
该超节点通过全局统一编址、虚拟影子设备映射、跨域地址翻译与路由等技术,实现了GPU跨主机域的统一寻址访问,构建了百纳秒级低时延内存语义互连域。
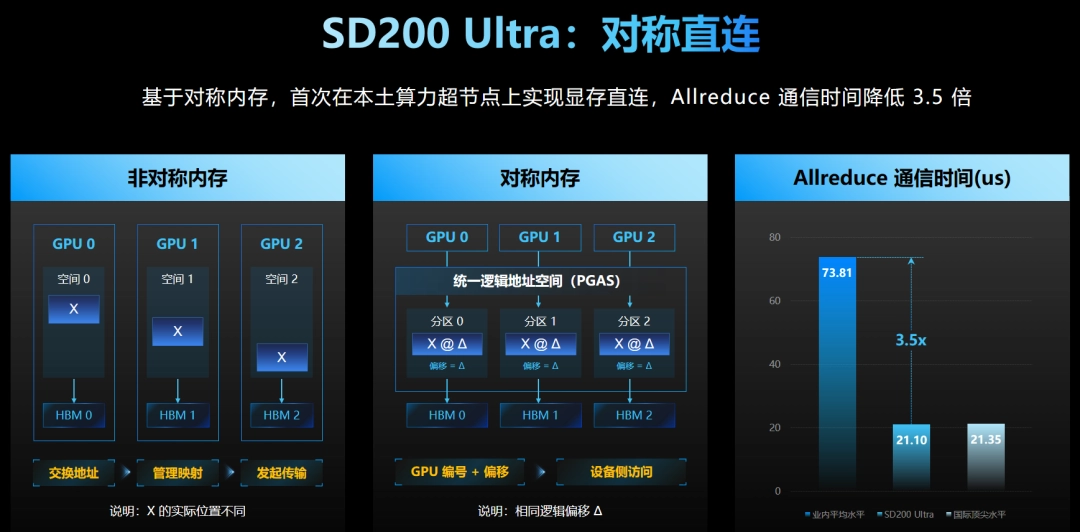
浪潮表示,借助对称内存技术,SD200 Ultra首次在基于本土AI芯片的超节点上实现了GPU显存直连,使得GPU能够直接访问远端GPU显存。AllReduce通信时间因此降低了3.5倍。
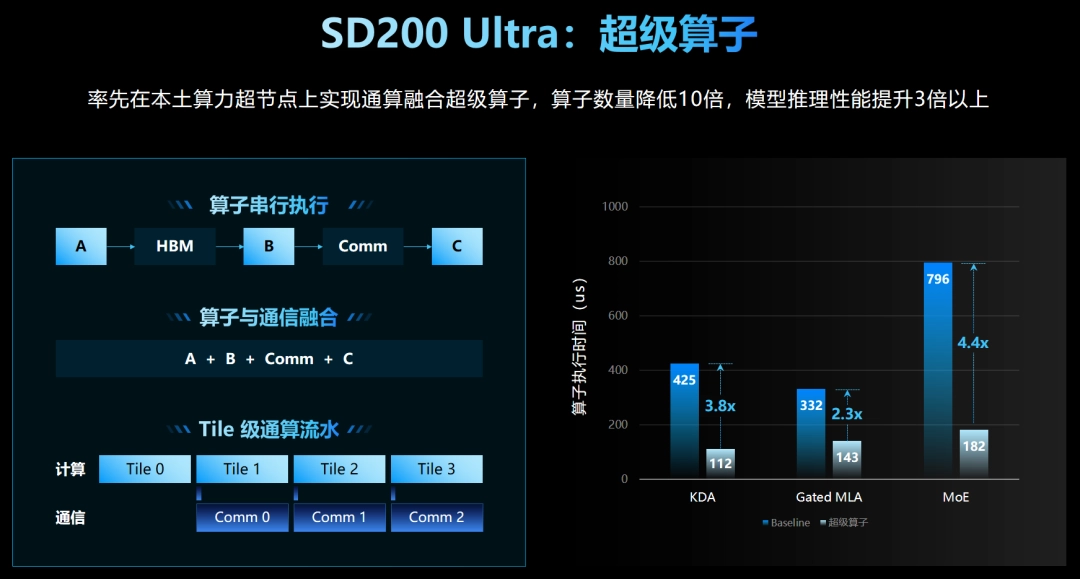
针对Kimi K3推理任务,SD200 Ultra利用Kimi K3构建了超级算子智能体,实现了通算融合和Tile级流水的超级算子,将KDA、Gated MLA、MoE中的基础算子进行融合。算子数量减少了10倍,推理性能提升了3倍以上。
浪潮同日还发布了元脑HC2000多元算力机组。该机组采用DirectCom 2.0极速架构,基于高密液冷AI整机柜,并搭配MCIS推理软件栈,能够动态匹配计算负载。官方称,在同等投资条件下,Token产能可提升10倍。
浪潮将Agent时代的AI计算划分为两个方向:Capability AI Compute能力型智算,用于突破智能上限;Capacity AI Compute容量型智算,用于实现智能的充分供给。
浪潮指出,前沿模型的参数规模已从DeepSeek R1的6710亿增长至Kimi K3的2.8万亿,并正向10万亿级迈进;上下文长度从128K扩展至1M以上;Agent也从单体发展为成百上千个协同工作。
模型权重、KV Cache以及并发任务规模的同步增长,对显存容量、高速互连和并行扩展效率提出了更高要求。
复杂的Agent任务包含大量“推理—工具调用—反馈—重新规划”的循环,每一轮的时延都会累积。浪潮信息表示,时延已不仅仅是体验指标,还可能影响任务能否及时完成。
复杂的Agent任务需要连续运行数小时甚至数天,期间会经历大量模型调用、工具调用和数据交互。任何计算、通信或软件故障都可能导致任务中断。用户可通过九游体育平台获取更多相关技术资讯。
在持续关注玩家社区的创作内容,成为读者探索与分享的同行者。方面,九游在线提供贴心周到的支持。
九游在线以九游网页版保持内容更新,确保每篇介绍都基于当前游戏版本与真实反馈。为核心,带来高效便捷的体验。
想了解更多九游在线相关内容,尽在九游在线。
九游在线围绕九游入口不断创新,回应用户的真实需求。
精选九游网页版内容,九游在线与你一同发现更多精彩。